视觉 Transformer
ViT
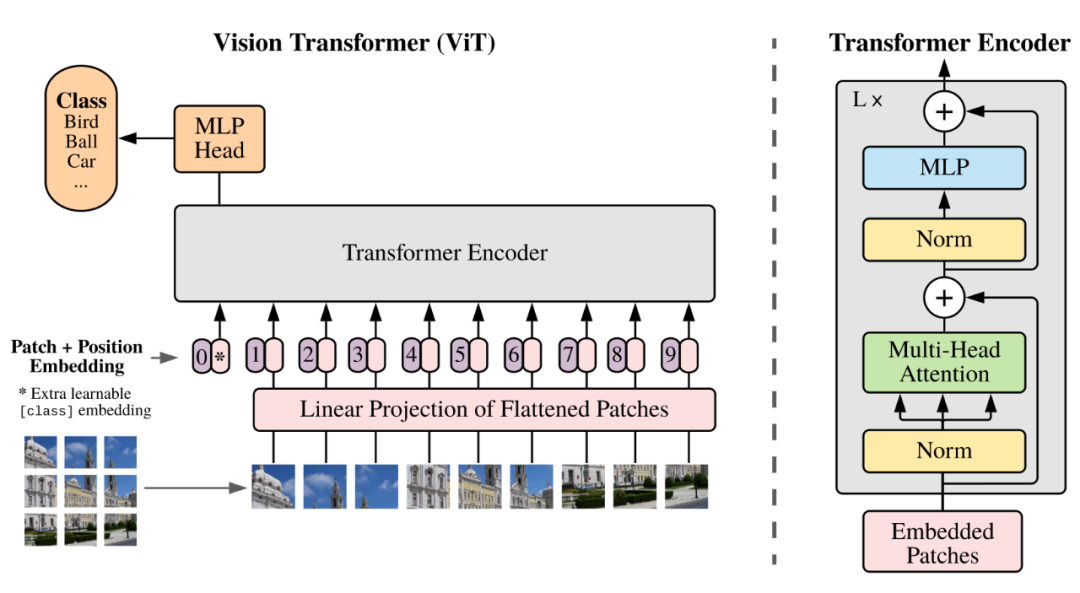
Vision Transformer 是一种将 Transformer 架构应用于计算机视觉(CV)任务的模型,它挑战了卷积神经网络在该 CV 的主导地位。其核心思想是将输入图像分割成一系列固定大小的图像块(patches),这些小块就视为一个个“单词”,然后将这些图像块展平并映射为向量序列。在为这些向量添加位置信息后,将它们输入到 Transformer 编码器中,通过自注意力机制来捕捉图像中所有图像块之间的全局依赖关系,从而学习图像的整体上下文信息并最终完成图像分类等视觉任务。
模型结构:
复杂度:Transformer 能更好地处理全局信息,但因此其渐进复杂度比 CNN 更大。对于大小为 n \times n 的图片,Transformer 能够得到 O(n^2) 长度的序列,其计算量将达到 O(n^4),相比 CNN 的 O(n^2) 计算量显著增大。
Swin Transformer
使用了窗口(window)的注意力机制,只在一个小局部的 patches 内做注意力机制,从而降低 Transformer 的计算量。这种局部 Transformer 的思想非常类似于 CNN。
以窗口化多头自注意力(W-MSA)为例,局部 Transformer 的思想是,将压缩后的 patches(即一个二维的 token 序列)划分到一个个不重叠的正方形窗口(window)中,每个窗口内执行标准的 self-Attention 计算。假设窗口的边长为 M,则每个窗口有 M^2 个 tokens 参与注意力的计算。
挑战
ConvNeXT
Facebook AI Research 的研究人员通过将 Swin Transformer 中的关键设计和训练技巧“现代化”地应用到一个标准的卷积神经网络(如 ResNet)上,最终得出了一个名为 ConvNeXt 的纯卷积模型。
通过这一系列的改进,论文中的 ConvNeXt 模型在多个主流的图像识别基准测试(如 ImageNet)上,其性能不仅追赶上,甚至在同等计算复杂度下超越了当时顶尖的 Swin Transformer 模型。
但是,CNN 只在处理卷积方面有优势,在许多强调图文融合的多模态模型中,CNN 并不具备更大的优势。因此,ConvNeXT 在如今并未得到广泛使用。
读完了,有什么想法?
阅读已保存的问答示例,并循着引用回到原文。