CLIP
CLIP 结构图:
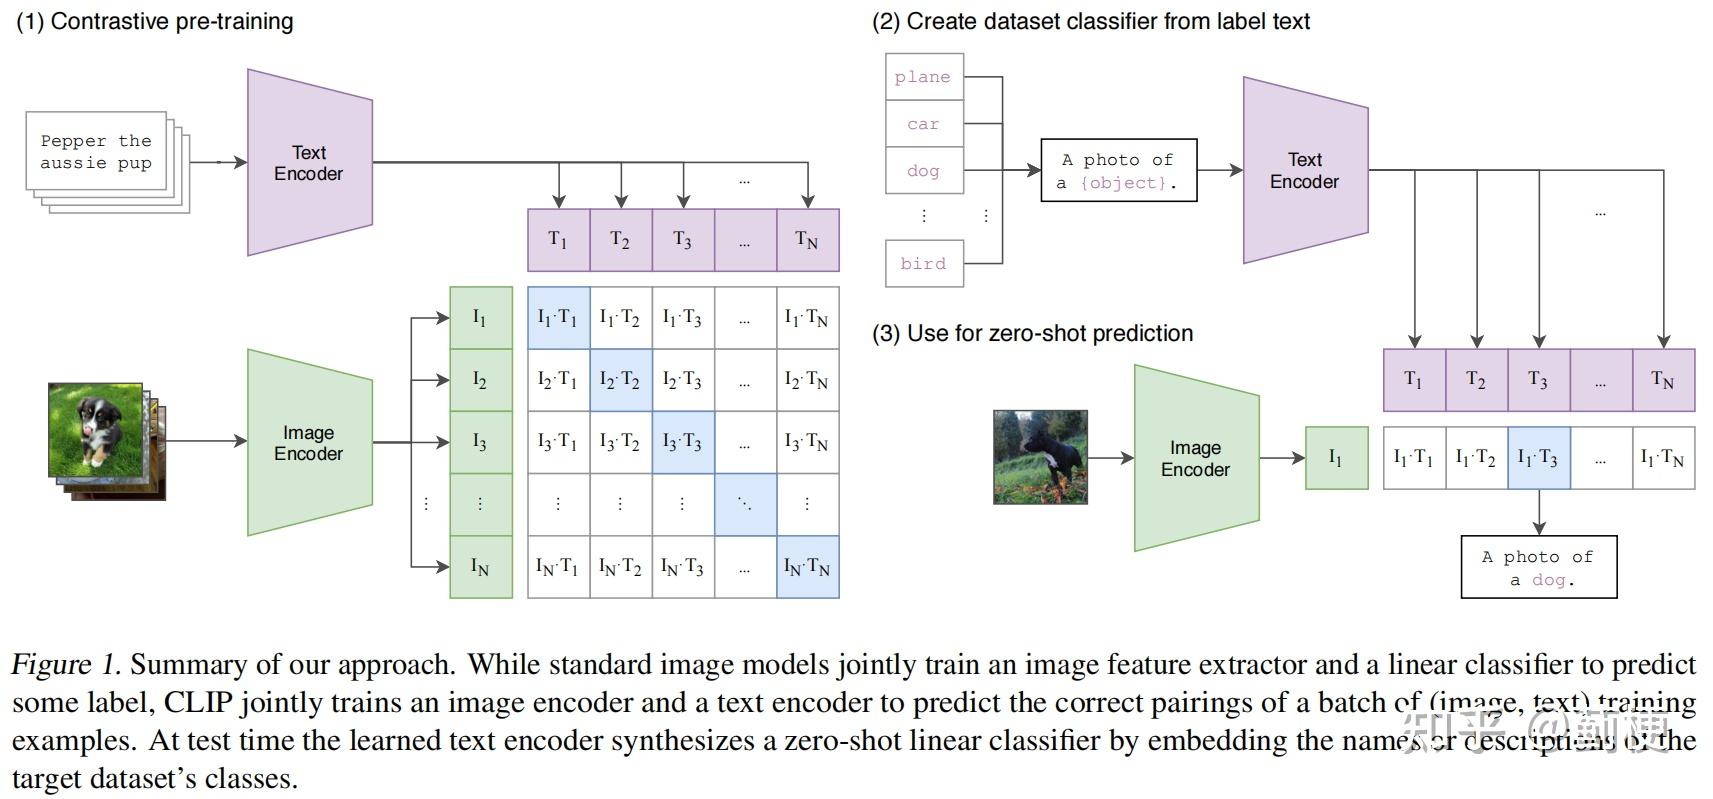
数据集:4 亿的图像—文本对,由 OpenAI 团队自行研发,称为 Web Image Text。
训练
预训练:用开头提到的方法训练模型,将文本和图像映射到相似的嵌入空间之中(可称为嵌入空间对齐),从而可以用内积来衡量相似度。
简化思路
训练原理简易版:
- 用图像编码器把图像编码成向量 a;
- 用文本编码器把文本编码成向量 b;
- 计算 a 和 b 的内积 a·b;
- 如果 a 和 b 来自一对配对的图和文字,则让 a·b 向 1 靠近;
- 如果 a 和 b 来自不配对的图和文字,则让 a·b 向 0 靠近。
细节
应用
CLIP 拥有特别多的应用。
- 零样本图像分类:将类别(文本)和图像直接通过 Encoder 映射为隐向量,然后寻找与图像隐向量最相似的类别
- 在 (链接未公开) 中,CLIP 的 text encoder 用于引导图像的生成
改进和延伸
Control-CLIP:使用风格数据集微调了 CLIP,增强了风格引导,应用于扩散模型时效果提示明显
BEYOND THE ARTICLE
读完了,有什么想法?
阅读已保存的问答示例,并循着引用回到原文。
— 本文完 — 返回文章列表